Automação de extração e classificação de documentos com IA
Público-alvo: Empresas que recebem grande volume de documentos (notas fiscais, contratos, comprovantes) e ainda digitam esses dados manualmente em outros sistemas.
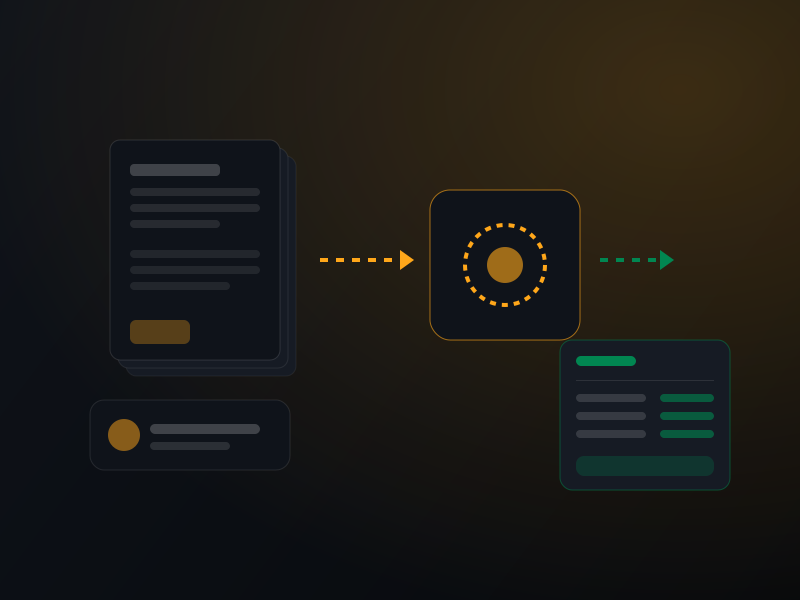
Aplicando a mesma expertise em IA que usamos em outros projetos, desenvolvemos um pipeline que lê documentos (PDFs e imagens escaneadas), extrai os dados relevantes em formato estruturado e classifica o tipo de documento automaticamente — com revisão humana apenas para os casos de baixa confiança.
O que o cliente precisava
- Eliminar a digitação manual de dados a partir de documentos recebidos
- Estruturar a informação extraída em um formato pronto para integrar com outros sistemas
- Classificar automaticamente o tipo de documento recebido
- Sinalizar apenas os casos duvidosos para revisão humana, em vez de revisar tudo
Nossa abordagem
Tratamos a extração como um pipeline com etapas independentes — leitura do documento, extração estruturada via LLM com schema definido, cálculo de confiança e roteamento — em vez de um único passo monolítico. Isso permite calibrar exatamente o quão automático o processo é: documentos com alta confiança seguem direto para o sistema de destino, e só os casos ambíguos exigem um humano, o que torna a automação segura mesmo quando o volume de documentos é alto.
Como resolvemos
Extração estruturada com schema definido
Em vez de devolver texto livre, o modelo é instruído a preencher um schema de dados específico para cada tipo de documento (por exemplo, valor, data, CNPJ, itens de uma nota fiscal), o que torna a saída diretamente consumível por outros sistemas sem processamento adicional.
Classificação automática do tipo de documento
Antes de extrair os dados, o pipeline identifica que tipo de documento está sendo processado, permitindo que diferentes categorias (nota fiscal, contrato, comprovante) sigam fluxos de extração e validação específicos para cada uma.
Roteamento por confiança para revisão humana
Cada extração recebe uma pontuação de confiança; documentos abaixo do limiar definido são encaminhados para revisão humana antes de seguir adiante, enquanto os demais são processados de ponta a ponta sem intervenção — equilibrando automação com segurança.
Destaques técnicos
- Extração de texto (OCR) combinada com LLM para interpretação e estruturação dos dados
- Saída estruturada validada contra um schema definido por tipo de documento
- Pontuação de confiança para decidir entre automação total e revisão humana
- Backend em FastAPI com persistência em PostgreSQL, pronto para integração via API
O resultado
Essa é outra frente em que aplicamos IA na prática: transformar documentos não estruturados em dados prontos para uso, reduzindo o trabalho manual de digitação e mantendo um humano no controle apenas onde a confiança da extração exige atenção.
- Extração de dados de documentos sem digitação manual
- Saída estruturada pronta para integrar com outros sistemas
- Classificação automática por tipo de documento
- Revisão humana concentrada apenas nos casos de baixa confiança
Tem um desafio parecido com este?
Conte pra gente o que você precisa e vamos te mostrar como podemos resolver — do jeito que resolvemos para este cliente.